Mimify
Agentes con perfiles de usuario real que navegan tu web, se atascan donde se atascaría tu gente y te cuentan por qué.
- Rol
- Producto, diseño y desarrollo · en solitario
- Estado
- En beta
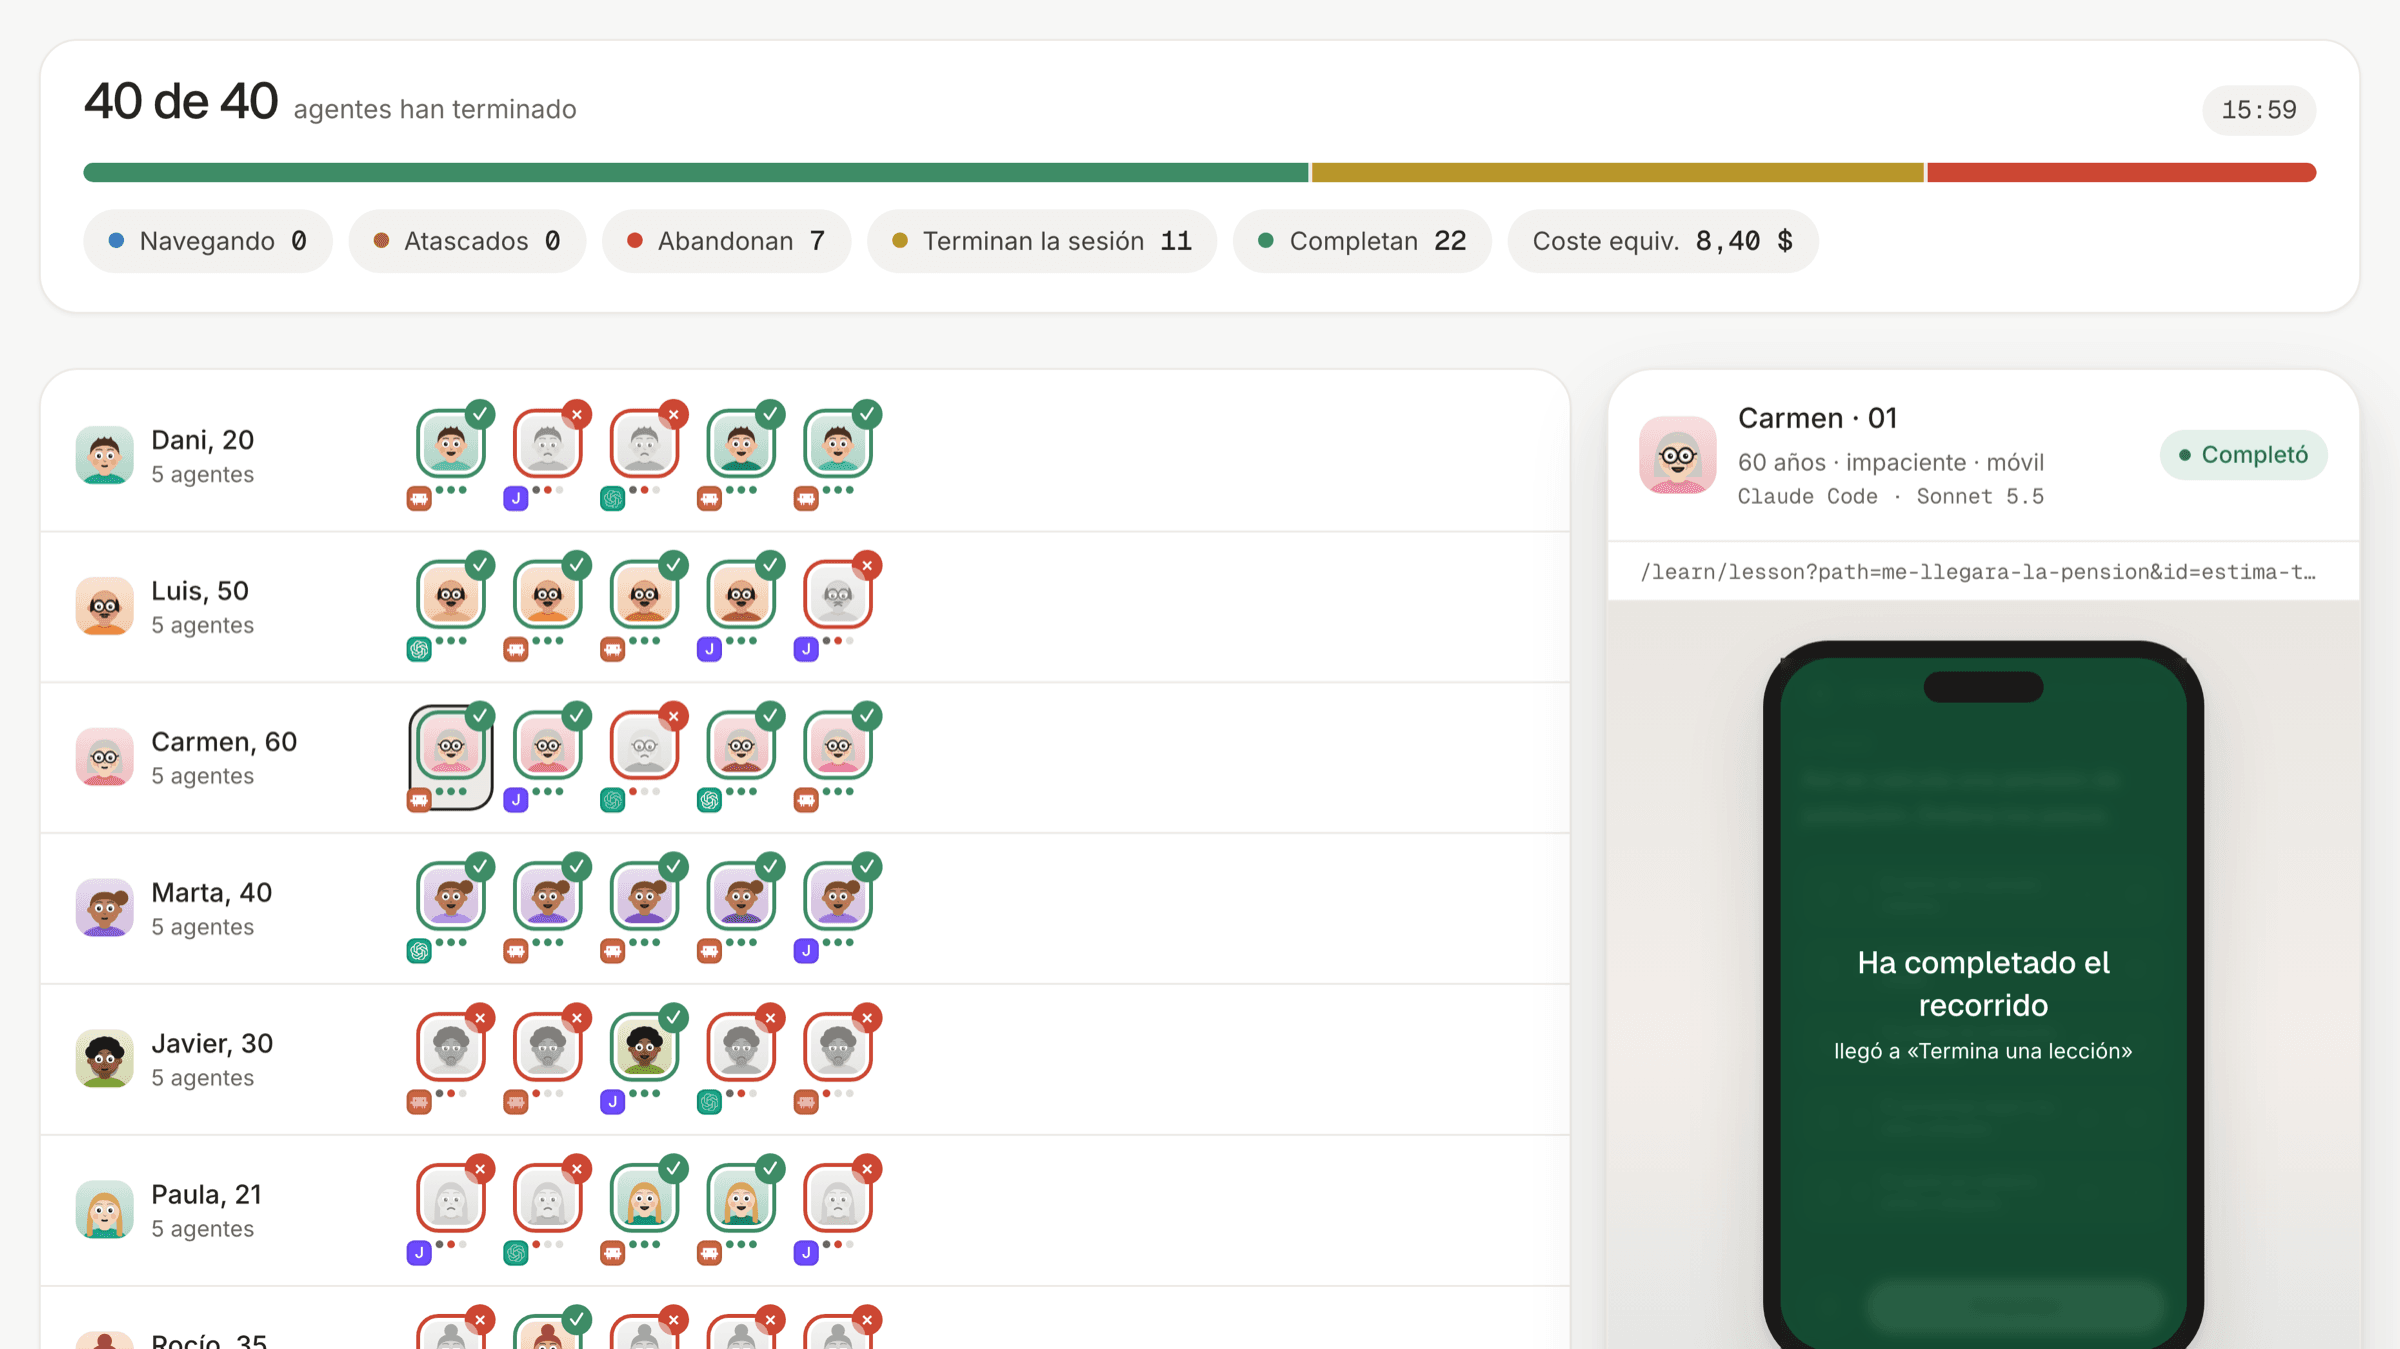
Un hallazgo falso hace desconfiar de todos los demás.
Lo difícil no es que un agente navegue una web. Es que el informe sea lo bastante fiable como para tocar código por él.
Probar un flujo con usuarios reales es lento y caro: reclutar, agendar, grabar y sacar conclusiones lleva semanas, así que en un producto pequeño casi nunca se hace antes de publicar. La analítica llega después y dice dónde se cae la gente, pero no por qué.
Los agentes que navegan webs ya existen, pero un agente genérico que completa una tarea no se parece a una persona de 60 años que desconfía de internet y abre la app desde el móvil. Y si el informe culpa a la web de un fallo de la propia prueba, nadie vuelve a fiarse de él.
Hacía falta algo a medio camino: rápido como un test automático, con la variedad de una muestra de personas y lo bastante honesto como para decir cuándo un resultado no vale.
Servidor local con solo tres dependencias. Sin framework: API, eventos en vivo por SSE y una interfaz en HTML, CSS y JS sin librerías.
Cada agente abre su propio Chromium, en móvil o escritorio, con cookies aisladas. Lee la pantalla como texto con los elementos numerados, incluido lo que tapa un banner.
Los agentes que preparan los estudios (analista, diseñador y creador de perfiles) usan el claude del usuario en modo headless, con su suscripción y sin tocar sus credenciales.
Servidor MCP y CLI para lanzar estudios y leer los hallazgos desde Claude Code en el repo de otro producto, o desde CI.
node:sqlite nativo, con una fila por estudio y otra por agente. Si el servidor se cae a mitad, el estudio sigue donde iba.
Once proveedores (Anthropic, OpenAI, Gemini, Mistral, DeepSeek, Groq, OpenRouter, Jev…). Mezclar modelos es a propósito: la falta de variedad es el mayor riesgo de los usuarios sintéticos.
Diseñador conversacional: describes qué quieres probar y un agente lee tu web y tu código en solo lectura, elige los avatares y deja el estudio listo para lanzar.
Avatares con contexto real: dinero, nivel técnico, paciencia y desconfianza del 1 al 5, objetivo y dispositivo. Si falta un perfil, otro agente lo crea.
Seguimiento en vivo de cada agente: dónde está, qué piensa y si avanza, se atasca o abandona.
Hallazgos P0–P2 con la evidencia en la voz del agente, el cambio propuesto y el fichero y la línea de código que hay que tocar, listos para Linear.
Entrevista al terminar: puedes preguntarle a cada agente, en primera persona, por qué se fue.
Salud del estudio: las visitas que invalidó la propia prueba (antibot, login, errores de la herramienta) salen de los resultados, y el informe lo dice.
Piloto con uno o dos agentes antes de un estudio grande, para no gastar 40 visitas en un entorno roto.
Perfiles de entorno local, staging y producción: en producción todo es solo mirar, con líneas rojas como pagar, comprar o borrar una cuenta.
Regresión entre versiones: el mismo estudio en cada rama o commit, con un comando que falla en CI si la finalización baja del umbral.
Pulsa para ampliar.
Un servidor Node local lo orquesta todo. Los agentes de preparación (analista de proyectos, diseñador de estudios y creador de perfiles) corren sobre Claude Code y dejan una configuración declarativa: URL, pasos del embudo con reglas verificables, entorno y avatares. El runner reparte los agentes entre los modelos elegidos y los lanza en paralelo con límites por proveedor. Cada agente es un bucle de observar, decidir y actuar sobre su propio Chromium: el lector convierte la página en texto con los elementos numerados, el modelo responde con una acción validada con JSON Schema y un buzón SMTP local recibe los correos de verificación. Al terminar, un analista cruza recorridos, entrevistas y el código del repo para redactar los hallazgos. Todo se guarda en SQLite y se sigue en vivo por SSE.
Los primeros estudios sacaron más fallos del motor que de las webs: agentes que daban por completado un paso en el que en realidad dudaban, informes que culpaban a la web de un fallo de la prueba y agentes ciegos a los gráficos. Cada uno era un hallazgo falso, y bastaba uno para dejar de creerse el resto. Por eso buena parte del trabajo acabó en lo que no se ve: el informe de salud, el piloto previo, los avisos de entorno y una corrección de optimismo, porque los usuarios sintéticos abandonan mucho menos que los reales. Lo siguiente es calibrarlo con la analítica real de Tesora; hasta entonces, lo que da son fricciones a revisar, no hechos.
Otros proyectos
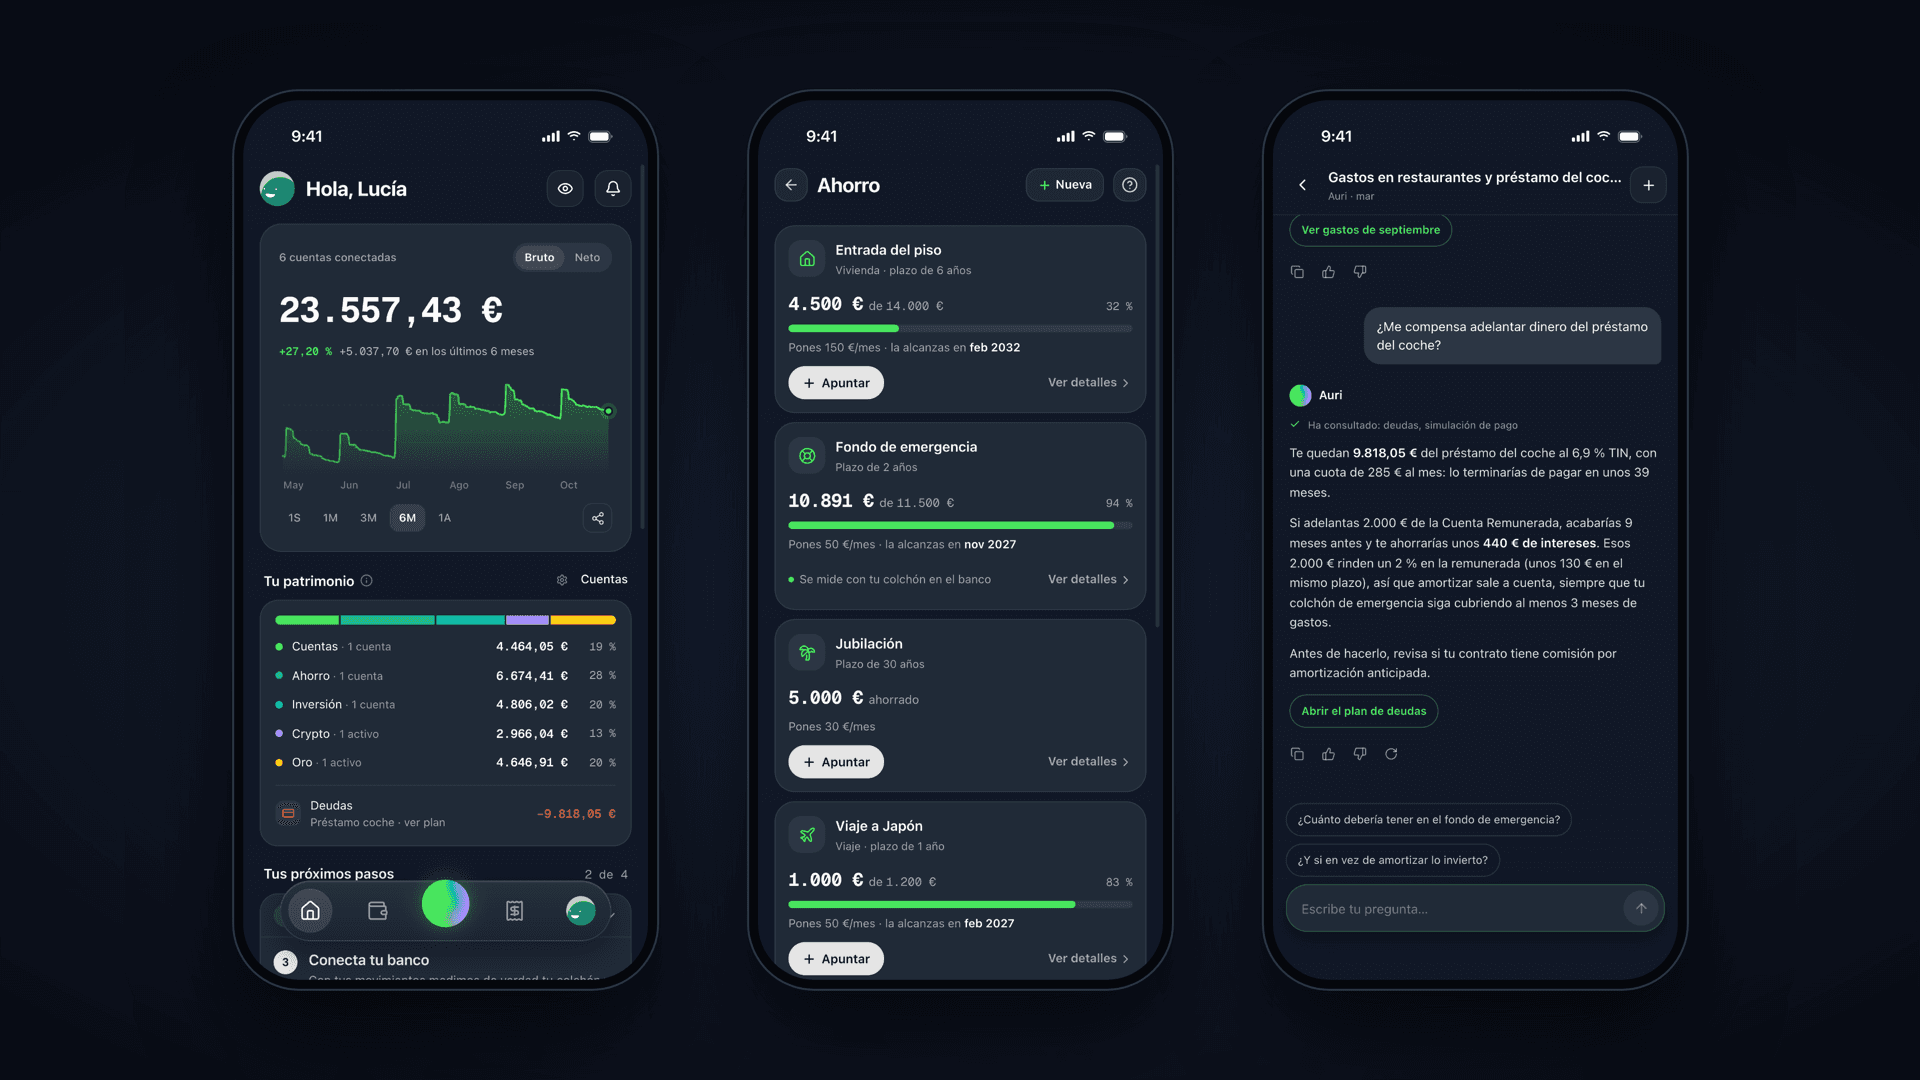
Plataforma de gestión financiera con IA: conecta tus bancos, unifica tu patrimonio y recibe asesoramiento inteligente.
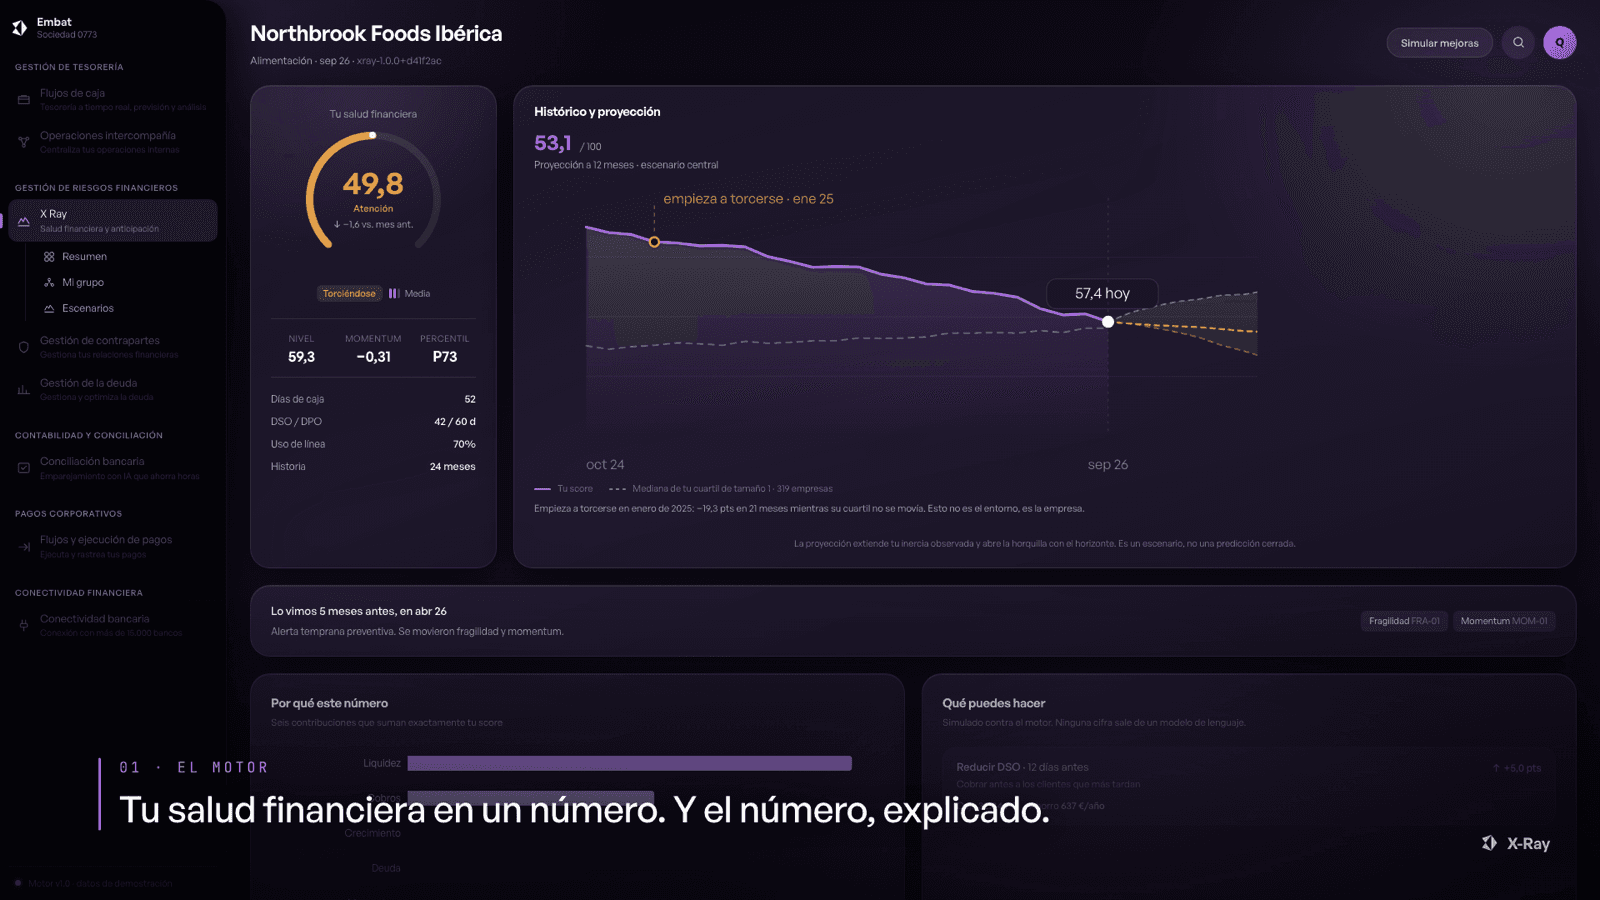
Salud financiera de 1.286 empresas leída en su rastro bancario, con alerta temprana y simulación de escenarios.
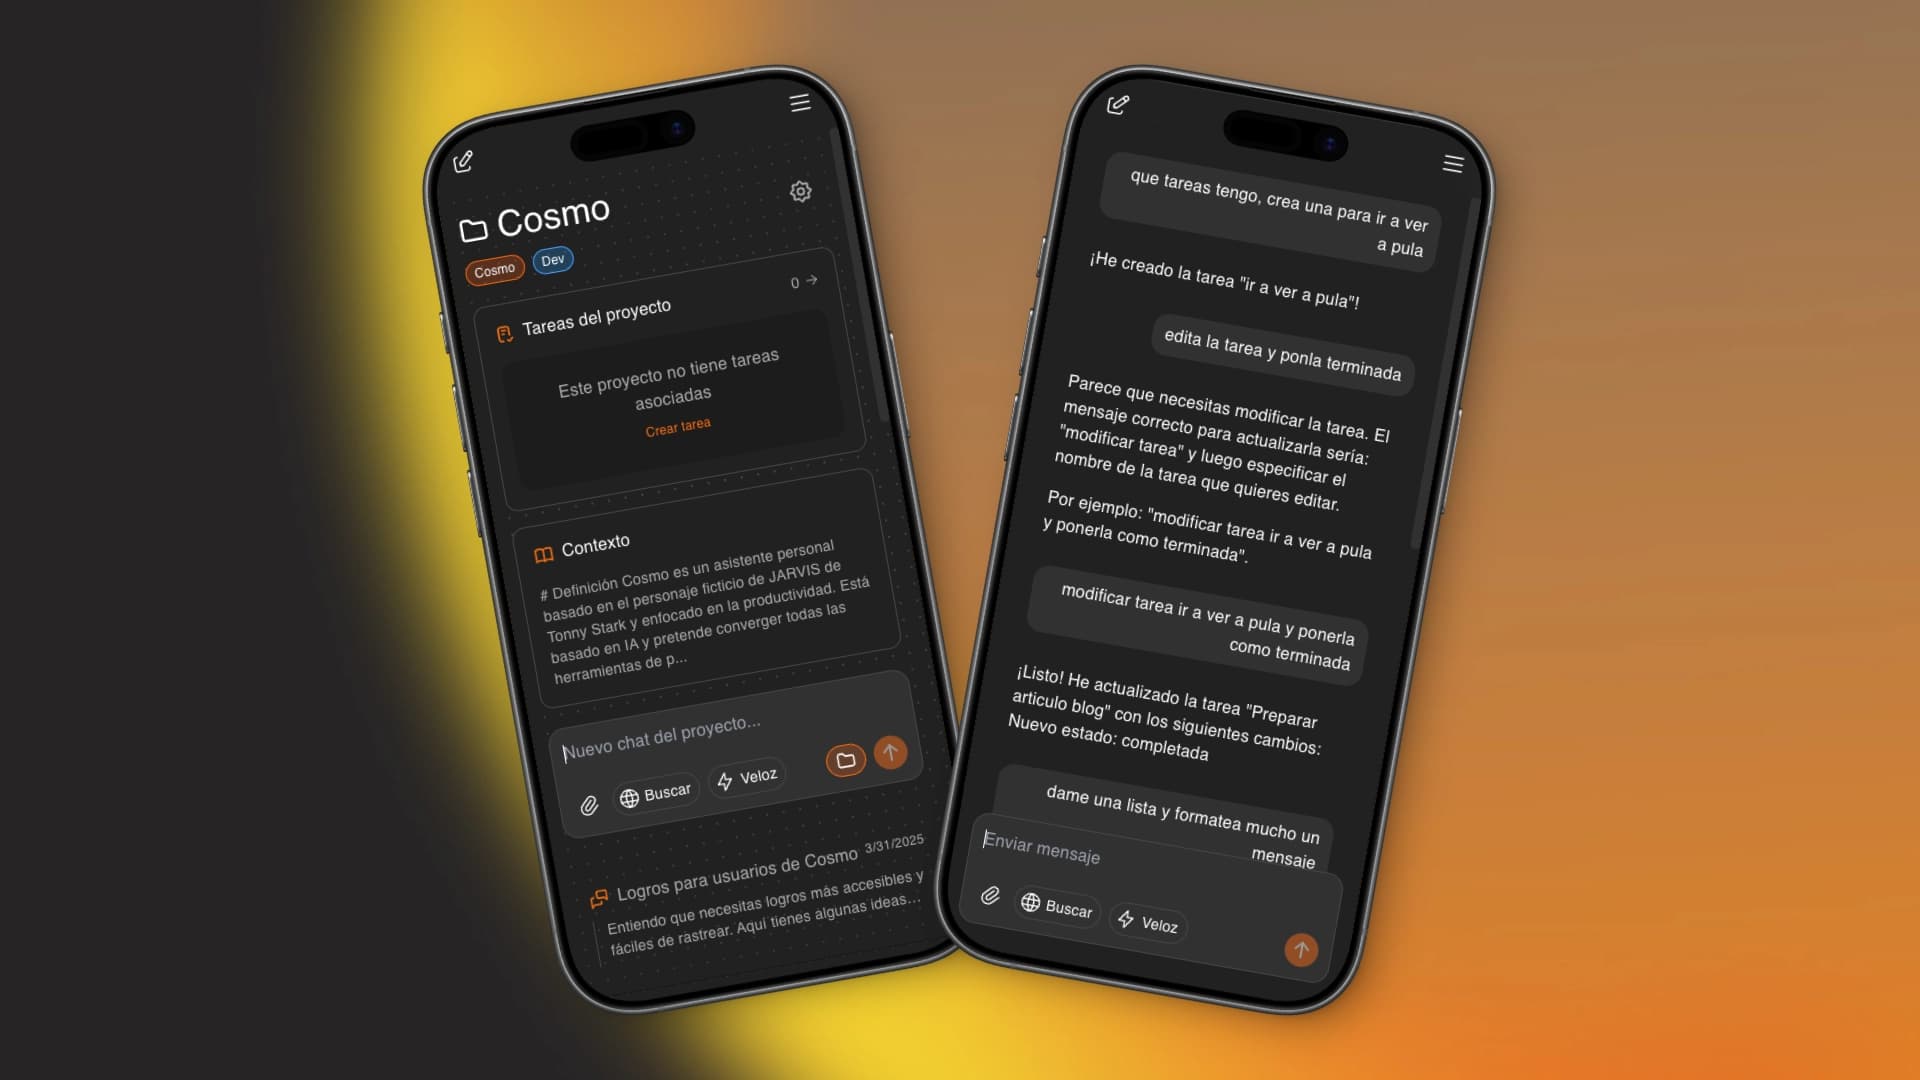
Asistente de productividad con IA: centraliza tus tareas, proyectos y apps en un solo chat personalizado.